

Un único implante cerebral permite hablar y gesticular a la vez mediante un avatar
Hablar, asentir o saludar al mismo tiempo vuelve a ser posible gracias a una interfaz capaz de interpretar varias intenciones directamente desde el cerebro. El avance acerca una comunicación más natural y expresiva a las personas con parálisis grave.
Por Enrique Coperías, periodista científico
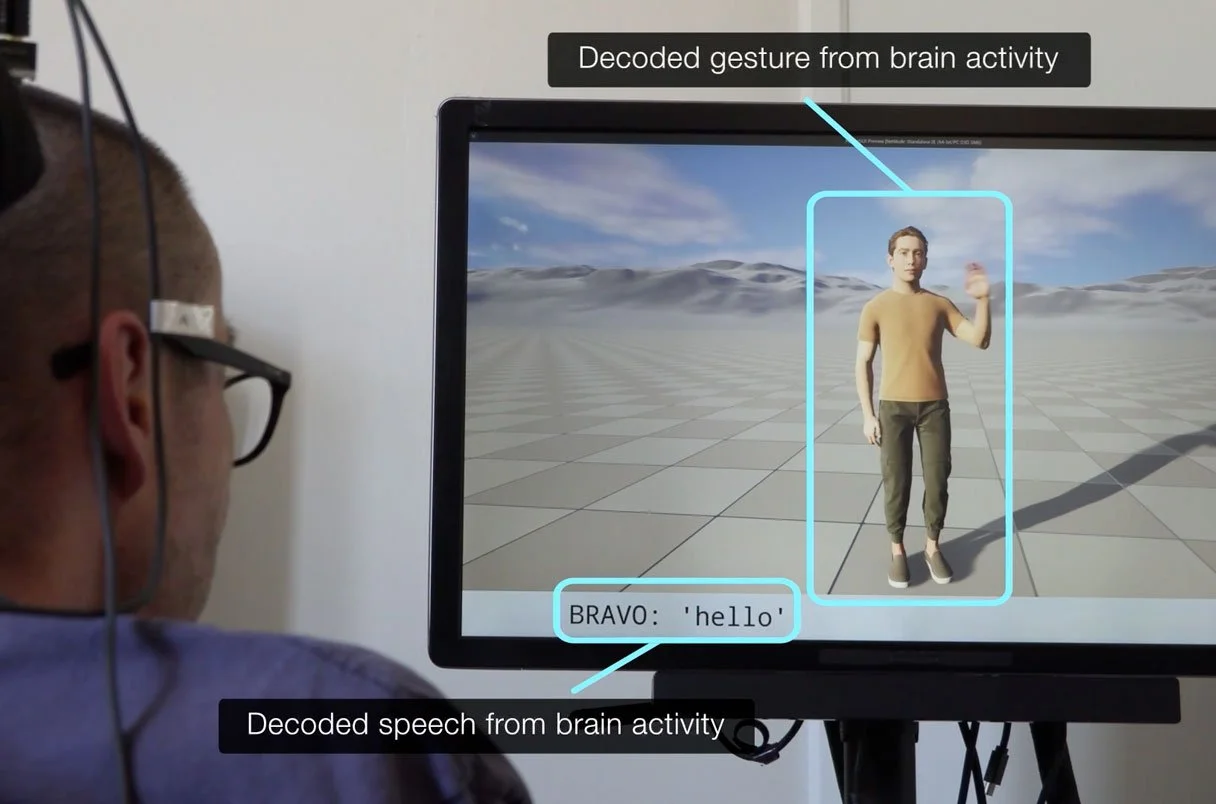
Un participante utiliza el implante cerebral para decir «hola» y saludar simultáneamente a través de un avatar, que transforma en tiempo real sus intentos de habla y movimiento en texto y gestos. Cortesía: Chang Lab / University of California San Francisco
Decir hola mientras se agita la mano parece un acto sencillo. Sin embargo, exige coordinar la boca, la laringe, el rostro y una parte del cuerpo en una coreografía que el cerebro ejecuta sin que reparemos en ella.
Para una persona con parálisis grave, esa naturalidad puede desaparecer por completo. No solo puede perderse la capacidad de hablar, sino también el repertorio de gestos que acompaña, matiza o incluso sustituye a las palabras.
Un equipo de la Universidad de California en San Francisco (UCSF) ha dado ahora un paso importante para recuperar ambos canales con un único implante cerebral. El sistema interpreta de forma simultánea los intentos de hablar y de mover la parte superior del cuerpo, y convierte esas señales en texto y en movimientos de un avatar digital personalizado.
El trabajo, publicado en Nature Neuroscience, es una prueba de concepto, no un dispositivo listo para aplicar a los pacientes en los hospitales. Demuestra que una sola interfaz cerebro-ordenador puede realizar varias tareas al mismo tiempo. Hasta ahora, la mayoría de estos dispositivos se habían especializado en una única función: producir palabras, escribir, desplazar un cursor o controlar una prótesis.
«Los autores [del avance] han dado un paso importante hacia el desarrollo de sistemas muy naturalistas para restaurar funciones en personas con parálisis”, valora el neurólogo Daniel Rubin, del Hospital General de Massachusetts, en declaraciones a la revista Science.
¿Cómo funciona el implante cerebral?
Recordemos que una interfaz cerebro-ordenador, también conocida como BCI por sus siglas en inglés, es un sistema que registra actividad cerebral y la traduce en órdenes para un ordenador, un sintetizador de voz, un cursor o una prótesis.
Los investigadores, dirigidos por el neurocirujano Edward Chang, implantaron en los voluntarios una malla de electrocorticografía de alta densidad sobre una zona amplia de la corteza sensoriomotora. Esta es es la zona del cerebro que recibe información de los sentidos y controla los movimientos voluntarios, incluidos los necesarios para hablar, gesticular o mover las extremidades.
A diferencia de otros implantes formados por diminutos electrodos que penetran en el tejido neuronal, esta cuadrícula descansa sobre la superficie cerebral y registra la actividad combinada de miles de neuronas.
La extensión de la malla permite captar señales relacionadas con dos grandes grupos de acciones:
✅ Los movimientos de los articuladores del habla, como los labios, la lengua, la mandíbula y la laringe.
✅ Los movimientos de las manos, los brazos, la cabeza y los ojos.
Los datos se envían a dos modelos de aprendizaje automático que trabajan en paralelo. Uno intenta reconocer las palabras o frases que la persona quiere pronunciar y el otro identifica el gesto que trata de ejecutar.
Hay que insistir en que el implante no lee pensamientos generales. Reconoce patrones de actividad cerebral asociados a intentos concretos de hablar o moverse para los que el sistema ha sido previamente entrenado.
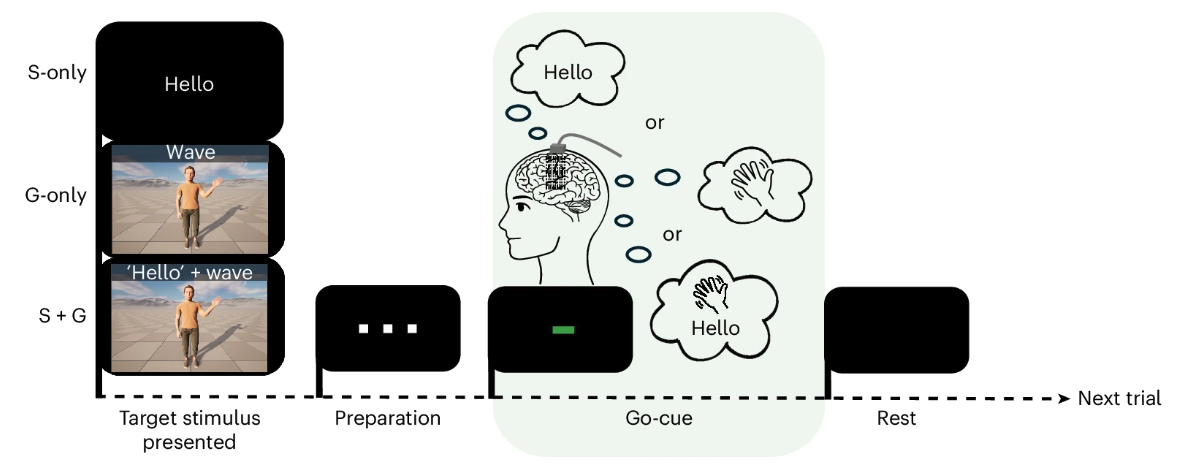
Esquema de los tres tipos de pruebas: intento de habla, gesto aislado y combinación simultánea de palabra y movimiento. Tras observar el estímulo y una breve cuenta atrás, el participante intenta ejecutar la acción indicada mediante el implante cerebral. Cortesía: Brosler, S. C., Liu, J .R., Silva, A. B. et al
Tres participantes con ictus o esclerosis lateral amiotrófica
En el estudio participaron tres personas con parálisis grave, que se corresponde con la pérdida total o casi total de la capacidad para mover voluntariamente varias partes del cuerpo y, en algunos casos, también para hablar, aunque la persona conserve sus capacidades cognitivas.
Dos voluntarios habían sufrido un ictus en el tronco encefálico y el tercero padecía esclerosis lateral amiotrófica (ELA), una enfermedad neurodegenerativa que daña progresivamente las neuronas encargadas de controlar los músculos, lo que causa con el paso del tiempo debilidad, parálisis y dificultades para hablar, tragar y respirar.
En una primera fase, los científicos comprobaron que el implante distinguía decenas de intentos de movimiento de diferentes partes del cuerpo. La organización general seguía, a grandes rasgos, el conocido mapa corporal de la corteza motora: el habla activaba con mayor intensidad zonas inferiores y los movimientos de las extremidades superiores, regiones más dorsales.
Sin embargo, las fronteras no eran tan precisas como sugería la representación clásica del homúnculo motor. Algunos electrodos respondían tanto al habla como a los gestos. Esta superposición indica que la corteza motora funciona como un mosaico de circuitos parcialmente entrelazados, y no como un tablero dividido en casillas independientes para cada parte del cuerpo.
Cien combinaciones de palabras y gestos
La prueba principal se realizó con dos de los participantes:
1️⃣ Uno de ellos ensayó cinco expresiones y cuatro gestos.
2️⃣ El otro, identificado como Bravo-6, practicó diez expresiones y diez gestos, entre ellos saludar, aplaudir, encogerse de hombros o asentir.
La combinación de ambos repertorios generaba un centenar de posibles combinaciones de palabras y movimientos. Durante los experimentos, los participantes debían intentar hablar, gesticular o hacer ambas cosas a la vez.
Bravo-6 todavía podía intentar vocalizar, aunque su habla no resultaba inteligible, e imaginaba los gestos sin producir movimientos visibles. El otro participante ensayaba las palabras en silencio y trataba de ejecutar los movimientos de forma mínima.
El desafío consistía en que la interfaz identificara cada acción y supiera cuándo debía permanecer inactiva. Si el participante intentaba hablar sin gesticular, por ejemplo, el modelo encargado de los movimientos tenía que interpretar correctamente que no debía activar el avatar.
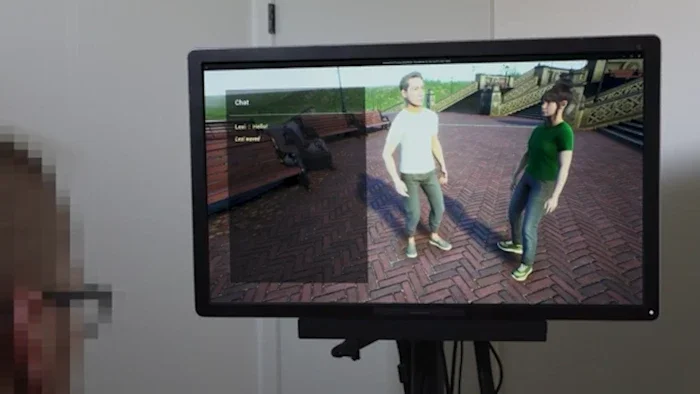
El implante descodifica los intentos de habla y los gestos del participante para controlar su avatar durante una conversación virtual con otro personaje. Cortesía: UCSF
Hablar y gesticular cambia la actividad cerebral
El experimento destapó un problema con importantes consecuencias prácticas: los algoritmos entrenados solo con palabras o con gestos aislados perdían precisión cuando ambas acciones se intentaban al mismo tiempo.
La actividad cerebral registrada al decir hola mientras se saluda con la mano no es una simple suma de la registrada al decir hola y al saludar por separado. La ejecución simultánea modifica parcialmente los patrones neuronales.
Para resolverlo, los investigadores entrenaron los modelos con una combinación de ejemplos aislados y simultáneos. De este modo, los algoritmos aprendieron a funcionar mejor en ambos contextos y redujeron las falsas activaciones.
La máquina, en definitiva, tuvo que aprender con situaciones parecidas a una conversación real, durante la cual el cerebro distribuye su atención y coordina diferentes sistemas motores al mismo tiempo.
Qué precisión alcanzó el avatar cerebral
Los resultados fueron prometedores, aunque todavía imperfectos. En las pruebas en tiempo real con Bravo-6, el sistema acertó el 70% de las expresiones y el 66 % de los gestos cuando ambos se intentaban de manera simultánea. La probabilidad de acertar por azar era del 9,1 %.
Durante pequeños bloques de conversación guiada, la precisión alcanzó el 75 % para el habla y el 85 % para los gestos. Las palabras descodificadas aparecían como texto en la pantalla, mientras el avatar ejecutaba el movimiento correspondiente. Así podía responder sí mientras asentía o decir hola mientras levantaba la mano.
El sistema incluso permitió una conversación virtual entre el avatar del participante y otro controlado por un investigador.
Los resultados principales del estudio
En las pruebas realizadas con el participante Bravo-6, el implante logró descodificar simultáneamente expresiones y gestos con una precisión muy superior a la esperable por azar.
| Prueba con Bravo-6 | Precisión |
|---|---|
| Expresiones y gestos simultáneos: habla | 70% |
| Expresiones y gestos simultáneos: gestos | 66% |
| Conversación guiada: habla | 75% |
| Conversación guiada: gestos | 85% |
| Nivel aproximado atribuible al azar | 9,1% |
Importante: son resultados preliminares obtenidos con un vocabulario limitado y en pruebas controladas. El sistema todavía no permite mantener una conversación completamente abierta y espontánea.
El sistema reconoce combinaciones que no había aprendido
Uno de los resultados más prometedores es que el decodificador pudo reconocer parejas de palabras y gestos que no había visto combinadas durante el entrenamiento.
Su eficacia fue semejante a la obtenida con las combinaciones conocidas. Esto sugiere que no sería necesario enseñar al algoritmo todas las parejas imaginables antes de utilizarlo.
La capacidad de generalizar será esencial para desarrollar interfaces con vocabularios más amplios. En una conversación real, las palabras pueden combinarse con innumerables expresiones faciales, movimientos de manos y posturas corporales.
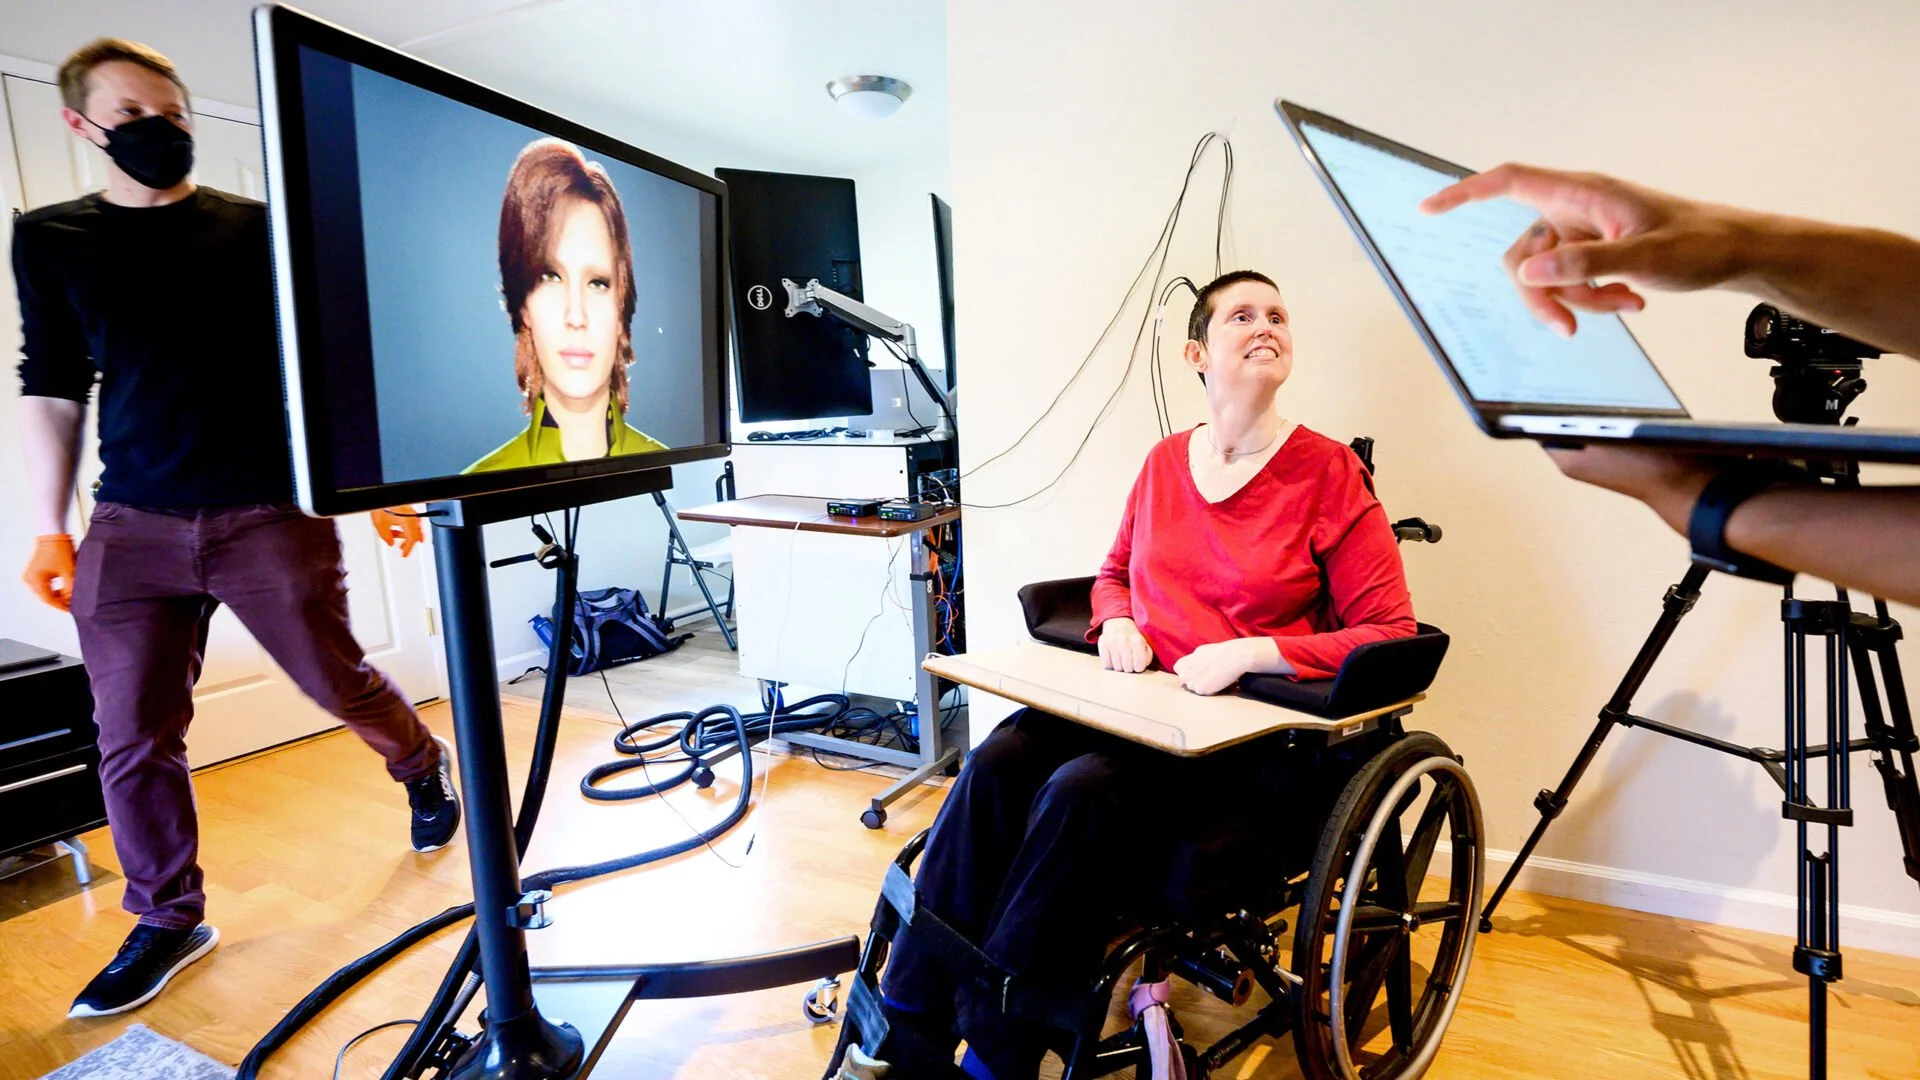
Ann, participante en una investigación dirigida por Edward Chang en la UCSF, utiliza una neuroprótesis que transforma sus señales cerebrales en habla y expresiones faciales de un avatar. A la izquierda, el coordinador de investigación clínica Max Dougherty. Foto: Noah Berger.
La carrera por devolver el habla a las personas paralizadas
El estudio forma parte de una rápida evolución de las neuroprótesis de comunicación. El propio grupo de Chang presentó en 2023 un sistema que convertía los intentos de habla de una mujer paralizada en texto, voz sintética y expresiones faciales de un avatar. En 2025, un equipo de la Universidad de California en Davis logró sintetizar casi instantáneamente la voz de un hombre con ELA a partir de 256 microelectrodos, incluida la entonación y la posibilidad de cantar melodías breves.
Y en junio de 2026, ese mismo grupo de neurocientíficos informó en Nature Medicine del uso doméstico de una interfaz que permitió a otro hombre con ELA comunicarse y controlar el cursor durante más de 3.800 horas a lo largo de diecinueve meses. Produjo casi dos millones de palabras a una media de 56 por minuto y conservó una precisión superior al 99% en pruebas pautadas.
Otra estrategia reciente intenta recuperar una acción aprendida en lugar de reconstruir directamente la voz. Un ensayo encabezado por Rubin descodificó los movimientos imaginados de los dedos de dos personas con tetraplejia para escribir en un teclado QWERTY. Una de ellas alcanzó veintidós palabras por minuto y un error del 1,6 %, cerca de la precisión de usuarios sin parálisis.
En conjunto, estas investigaciones muestran que el objetivo ya no consiste únicamente en demostrar que una señal cerebral puede mover algo en una pantalla. El reto es transformar esa capacidad en una forma de comunicación rápida, estable, expresiva y utilizable fuera del laboratorio.
Las limitaciones del nuevo implante cerebral
El dispositivo descrito en Nature Neuroscience todavía presenta obstáculos importantes:
✅ Solo se ha estudiado en tres personas y la descodificación simultánea se probó en dos.
✅ El repertorio máximo fue de diez expresiones y diez gestos.
✅ El sistema clasifica respuestas predefinidas, pero no descodifica una conversación abierta.
✅ Las palabras se muestran como texto; el avatar no genera todavía un habla libre y continua en este experimento.
✅ Los gestos son animaciones digitales prediseñadas, no movimientos físicos reconstruidos.
✅ El rendimiento varió entre participantes y tipos de movimiento.
✅ Su funcionamiento requiere cirugía cerebral y equipos externos.
✅ La seguridad, estabilidad y utilidad clínica deberán confirmarse en estudios más amplios y prolongados.
Por tanto, el trabajo no demuestra que las personas con parálisis puedan mantener ya una conversación completamente natural mediante un avatar. Demuestra que una sola superficie de registro cerebral contiene información suficiente para descodificar dos formas de expresión al mismo tiempo.
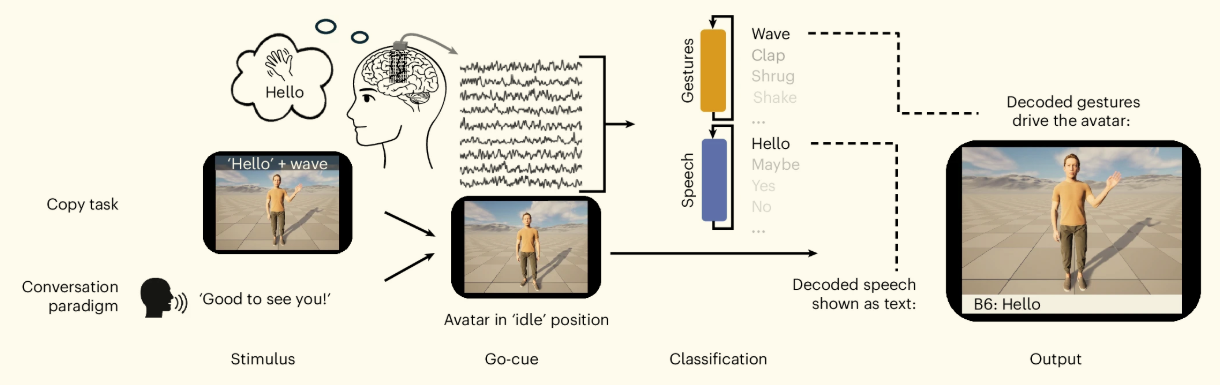
Esquema del funcionamiento del sistema en tiempo real: la actividad cerebral de Bravo-6 se envía simultáneamente a dos decodificadores, que identifican entre diez expresiones y diez gestos. El habla aparece como texto y los movimientos reconocidos son reproducidos por un avatar personalizado. Cortesía: Brosler, S. C., Liu, J .R., Silva, A. B. et al
De los avatares a los brazos robóticos
Recuperar la comunicación no equivale únicamente a devolver palabras. Un encogimiento de hombros puede expresar duda; un asentimiento puede reforzar un acuerdo, y una mano levantada puede llamar la atención antes de hablar.
«Como campo, queremos ayudar a las personas paralizadas a expresarse de una forma más plena», resume el investigador Sergey Stavisky, de la Universidad de California en Davis, en declaraciones a Science.
Chang considera que estos avatares digitales pueden convertirse en un paso intermedio hacia sistemas robóticos capaces de interactuar con el mundo físico.
Samantha Brosler, primera autora del estudio, propone una escena cotidiana: las personas hablamos mientras cocinamos. En el futuro, alguien con parálisis podría conversar mientras utiliza un brazo robótico para manipular objetos.
Antes será necesario ampliar el vocabulario, reducir el tiempo de respuesta, descodificar acciones continuas y conseguir que los algoritmos comprendan movimientos nuevos sin tener que entrenarlos uno por uno. Pero la meta comienza a perfilarse: una única conexión con el cerebro que no obligue al usuario a escoger entre hablar, señalar o actuar, sino que le devuelva la posibilidad profundamente humana de hacer varias cosas a la vez.▪️(16-septiembre-2026)
⏱️ LO MÁS IMPORTANTE DEL ESTUDIO, EN 30 SEGUNDOS
- Un solo implante para dos formas de comunicación: el dispositivo descodifica simultáneamente los intentos de hablar y de realizar gestos con la parte superior del cuerpo.
- Las señales se convierten en texto y movimiento: las expresiones reconocidas aparecen escritas en la pantalla, mientras un avatar personalizado reproduce los gestos.
- Hablar y gesticular no es una simple suma: la actividad cerebral cambia cuando ambas acciones se intentan a la vez, por lo que el algoritmo debe entrenarse con situaciones simultáneas.
- Resultados muy superiores al azar: en las pruebas en tiempo real con uno de los participantes, el sistema acertó el 70% de las expresiones y el 66% de los gestos simultáneos.
- Puede reconocer combinaciones nuevas: el decodificador identificó parejas de palabras y gestos que no había visto juntas durante el entrenamiento.
- Todavía es una prueba de concepto: solo participaron tres personas y el repertorio máximo fue de diez expresiones y diez gestos. Aún no permite mantener una conversación abierta y espontánea.
- El objetivo final es una comunicación más natural: en el futuro, esta tecnología podría combinar habla, gestos, cursores y brazos robóticos mediante una única conexión con el cerebro.
Fuente: Brosler, S. C., Liu, J .R., Silva, A. B. et al. Simultaneous speech and gesture decoding for multimodal communication in paralysis. Nature Neuroscience (2026). DOI: https://doi.org/10.1038/s41593-026-02446-2
🦖 NO TE PIERDAS LA CIENCIA QUE ESTÁ CAMBIANDO EL MUNDO
- Cada domingo seleccionamos para ti las noticias y los descubrimientos científicos más fascinantes de la semana, explicados con rigor, claridad y el estilo de RexMolón, la Ciencia en Acción.👉 SUSCRÍBETE GRATIS A LA NEWSLETTER DE REXMOLÓN
-
Si quieres recibir las noticias de ciencia de RexMolón cada día, únete a RexMolón News en WhatsApp, el canal donde compartimos las noticias según se publican.👉 ÚNETE GRATIS A REXMOLÓN NEWS
