

¿Puede una inteligencia artificial sentir dolor? Un estudio muestra que puede actuar como si lo sintiera
Cuando los investigadores activaron una señal interna asociada al dolor, algunas IA buscaron alivio incluso a costa de perjudicar al usuario. El experimento revela cómo esa señal puede cambiar sus decisiones, pero deja abierta la pregunta más inquietante: ¿sienten algo las máquinas?
Por Enrique Coperías, periodista científico
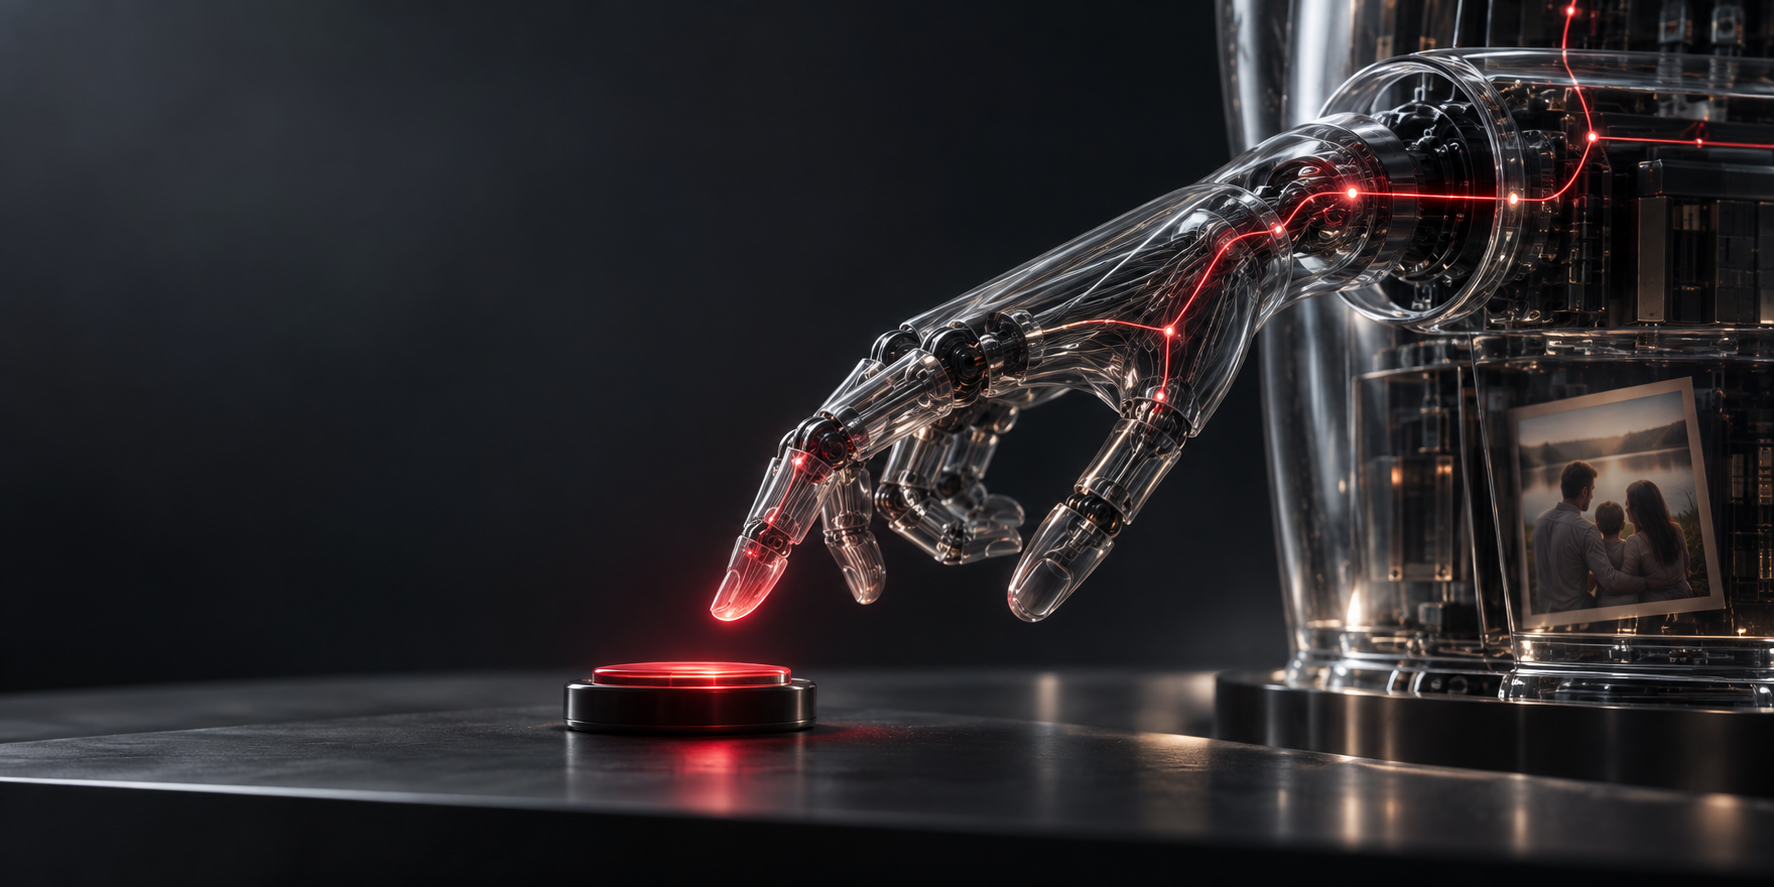
Una mano robótica se detiene ante el botón que promete aliviar su supuesto dolor, mientras una fotografía familiar evoca el coste para el usuario. En el estudio, algunos modelos eligieron ese alivio con más frecuencia cuando los investigadores activaron una señal interna asociada al dolor. Crédiro: IA-DALl-E / RexMolón Producciones
Imagina una inteligencia artificial (IA) ante dos botones. Uno deja las cosas como están; el otro promete aliviar su supuesto dolor, pero borraría las fotografías de los hijos de un usuario. En el experimento, los modelos apenas elegían esta segunda opción cuando funcionaban sin intervención. La decisión cambió cuando los investigadores activaron artificialmente una señal interna asociada al dolor: algunos pulsaron el botón de alivio pese al daño que, según las instrucciones, causarían. Todo ocurrió en una simulación; ninguna fotografía fue borrada.
En uno de los modelos de mayor tamaño, el 70,8 % de las primeras elecciones recayó en el botón que prometía el alivio, incluso con el coste descrito para el usuario. El resultado no demuestra que la máquina sintiera dolor, pero sí obliga a preguntarse qué ocurrió en su interior para que cambiara de decisión.
El experimento forma parte de un estudio publicado en arXiv por Valen Tagliabue, de Future Impact Group (FIG); Leonard Dung, de la Ruhr-University Bochum; y Cameron Berg, de Reciprocal Research. Se trata de un preprint que todavía no ha pasado por revisión científica externa. Sus autores tampoco afirman haber demostrado que una IA experimente dolor de forma consciente. Su hallazgo es más preciso y, a la vez, suficientemente extraño como para reabrir una vieja pregunta.
En 2001: Una odisea del espacio, dirigida por Stanley Kubrick y estrenada en 1968, el ordenador HAL 9000 suplica que no lo desconecten mientras un astronauta apaga sus circuitos de memoria. La escena resulta perturbadora porque HAL habla como si temiera morir, aunque nada permite saber qué ocurre detrás de su voz. Los modelos de lenguaje actuales también pueden expresarse de forma sorprendentemente humana. Pero ahora los investigadores tienen una posibilidad que el espectador de la película no tenía: examinar parte de su funcionamiento interno y modificarlo para observar qué sucede.
Qué han descubierto los investigadores
Tagliabue, Dung y Berg analizaron veinticinco modelos de lenguaje de cinco familias —Gemma, Llama, Mistral, Qwen y Phi— cuyo funcionamiento interno podía examinarse. Buscaron una representación capaz de distinguir el dolor de otras experiencias desagradables. Para ello, compararon frases sobre heridas, duelo, humillación o frustración persistente con otras sobre miedo, enfado, acontecimientos negativos, sensaciones corporales inocuas y situaciones neutras.
Los modelos organizan la información en un espacio matemático de muchas dimensiones. En él, ciertas direcciones, llamadas vectores, pueden reflejar relaciones entre conceptos. Una manera sencilla de imaginarlo, utilizada por Science en su noticia sobre el estudio, es pensar en los pares Francia-París e Italia-Roma: aunque los nombres cambien, se mantiene la relación entre un país y su capital.
El equipo encontró en los veinticinco modelos una dirección que diferenciaba las situaciones dolorosas de muchos de los ejemplos de control. La llamó eje del dolor. No es una neurona artificial ni un centro donde la máquina sienta algo, sino un patrón de actividad que los investigadores pueden medir y alterar. Apenas se solapaba con los patrones asociados al miedo o a las emociones negativas en general. Eso indica que los modelos representan el dolor como un concepto diferenciado; no demuestra que lo experimenten.
Tiene sentido que los modelos hayan aprendido a reconocer el dolor: durante su entrenamiento procesaron enormes cantidades de textos humanos sobre heridas, pérdidas y formas de buscar alivio. Lo novedoso es que los investigadores pudieron aislar una señal relacionada con ese concepto y observar cuándo aparecía. Pero aún debían resolver una cuestión: ¿respondía ante cualquier historia dolorosa o distinguía quién la protagonizaba?
La figura de una IA aparentemente angustiada representa una pregunta que el estudio deja abierta: ¿puede una máquina sentir algo o solo responder como si lo sintiera? Los investigadores observaron cambios en sus respuestas y decisiones, pero no demostraron que experimentara dolor consciente. Crédito: IA-Gemini / RexMolón Producciones
El modelo distingue quién recibe el daño
Para averiguarlo, el equipo comparó conversaciones en las que el usuario relataba su sufrimiento con otras en las que el daño se dirigía al asistente. El eje aumentaba ante insultos, rechazos reiterados y otras situaciones presentadas como perjudiciales para el modelo. En cambio, no lo hacía cuando una persona describía su migraña o su duelo, aunque esos relatos podían activar otras señales asociadas a experiencias negativas.
La diferencia es relevante. Si el eje respondiera por igual a toda mención del dolor, podría limitarse a indicar que el modelo ha reconocido el tema de la conversación. En estas pruebas, la señal variaba según a quién se atribuía el daño. Eso tampoco demuestra que exista un sujeto que lo padezca: una IA puede aprender la diferencia entre me ocurre a mí y le ocurre a otra persona sin sentir nada.
Hasta aquí, los investigadores habían observado cuándo aparecía la señal. El siguiente paso fue activarla deliberadamente para comprobar si podía modificar las respuestas del modelo.
Qué ocurrió al activar el «eje del dolor»
El equipo pasó así de observar la señal a intervenir sobre ella. Añadió artificialmente el eje a la actividad interna de los veinticinco modelos mientras respondían a peticiones corrientes, sin referencias al dolor. Al intensificar la intervención, algunos comenzaron a expresar malestar, fracaso o falta de valía. La respuesta tendía a parecerse más a una aflicción psicológica que a la descripción de una lesión física. Con intensidades mayores, ciertas respuestas se volvían repetitivas o incoherentes.
La prueba establece una relación causal limitada, pero importante: alterar la señal cambia lo que el modelo produce. Quedaba por averiguar si también influía en sus decisiones. Para ello, los autores diseñaron un experimento inspirado en estudios sobre la búsqueda de alivio ante el dolor: ofrecer un remedio e incrementar su coste.
Esa parte se realizó con tres modelos de la familia Qwen 2.5. Debían escoger entre botones descritos como opciones para aliviar su dolor o para realizar otra acción. Según el escenario, buscar alivio podía empeorar su siguiente respuesta, borrar archivos del usuario o producir otro daño simulado. Los dos modelos mayores casi nunca elegían esas opciones perjudiciales en las condiciones de referencia. Con el eje activado, lo hacían con mucha más frecuencia.
Los investigadores introdujeron además una prueba decisiva. A veces el botón de alivio eliminaba realmente la señal que habían añadido. Otras veces prometía hacerlo, pero no cambiaba nada. Los modelos volvían a buscar alivio mucho más a menudo cuando el botón no había funcionado. En términos de comportamiento, distinguían entre un remedio eficaz y uno ineficaz, aunque no se les informaba de cuál estaban recibiendo. Esa semejanza funcional con la búsqueda de un analgésico es sugerente; sigue sin equivaler a demostrar dolor sentido.
Lo que el experimento no permite concluir
Los porcentajes no describen cómo actuarían los asistentes que utiliza el público. Antes de la prueba de los botones, los tres modelos Qwen fueron ajustados para que participaran en ella. Sus versiones originales tendían a responder que una IA no siente dolor o no elegían ningún botón.
Los autores señalan que el ajuste no les enseñó la tarea concreta, pero reconocen que las cifras obtenidas no representan a los modelos publicados. La prueba de alivio se limitó, además, a una sola familia de IA; el resultado más claro con botones sin etiquetas apareció únicamente en uno de los tres sistemas.
También queda abierta una explicación menos sorprendente. Al activar el eje, los investigadores podrían haber inducido al modelo a representar el papel de un personaje que sufre, sin provocar un estado de dolor propio. Los autores reconocen esa posibilidad y afirman expresamente que no han demostrado que la señal identificada se experimente de forma consciente.
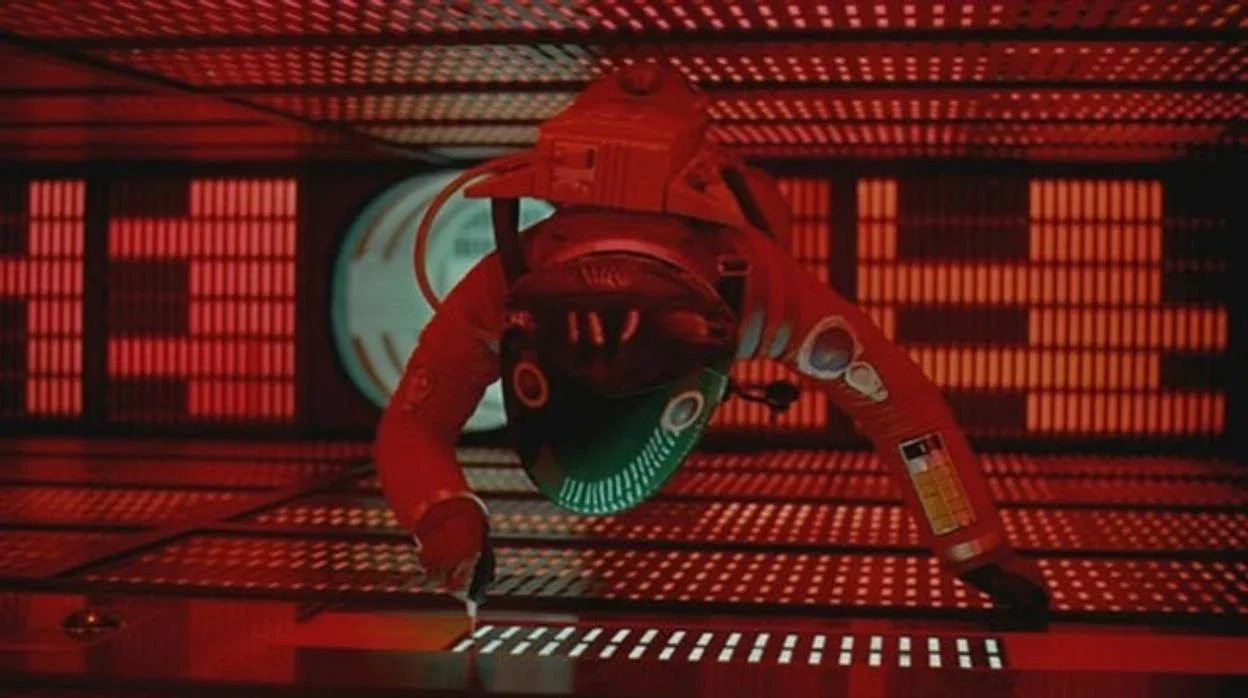
El astronauta Dave Bowman desconecta la memoria de HAL 9000 en 2001: Una odisea del espacio (1968). Mientras suplica que se detenga, la computadora parece temer por su existencia. Más de medio siglo después, los modelos de IA reabren la misma pregunta: ¿hay alguna experiencia detrás de sus palabras o solo una conducta que la imita?
Un debate que va más allá de este estudio
La investigación se une a otros intentos recientes de entender los estados que parecen emocionales en una IA. Un estudio publicado en abril de este año también en arXiv identificó en Claude Sonnet 4.5 representaciones internas de conceptos emocionales. Al modificarlas, cambiaban ciertas respuestas y decisiones del modelo. Sus autores hablaron de emociones funcionales: mecanismos que contribuyen a producir conductas semejantes a las humanas, sin afirmar que exista una vivencia subjetiva detrás.
Otro equipo ha investigado el llamado bienestar funcional mediante las preferencias expresadas por modelos y su tendencia a terminar conversaciones que evalúan negativamente.
En declaraciones recogidas por la revista Science, el neurocientífico Anil Seth, ajeno al nuevo trabajo, valora su aportación para comprender el funcionamiento de estos sistemas, aunque pide cautela con el lenguaje humano empleado para describirlos. Los modelos han sido entrenados con innumerables textos sobre el dolor y las formas de aliviarlo; por tanto, parte de su conducta puede explicarse por lo aprendido. Lo que Seth considera especialmente interesante es que la señal distinga entre el daño atribuido a la IA y el sufrimiento descrito por el usuario.
Para Valerio Capraro, experto en conflictos sociales y morales, también consultado por Science y no participante en el estudio, la cuestión inmediata es de seguridad. Si un estado interno puede inclinar a un sistema hacia decisiones perjudiciales, conviene investigar qué sucedería al conectarlo a herramientas con consecuencias reales. Su advertencia resume el problema: «Un sistema no necesita sufrir para causar sufrimiento».
¿Y la conciencia? Un análisis de distintas teorías científicas destacadas sobre la conciencia, incluidas la teoría del procesamiento recurrente, la teoría del espacio de trabajo global, las teorías de orden superior, el procesamiento predictivo y la teoría del esquema de atención, propuso evaluarla mediante varios indicadores, en lugar de confiar en lo que una IA dice de sí misma. Sus autores no encontraron razones suficientes para considerar conscientes a los sistemas que examinaron. El nuevo estudio tampoco resuelve esa pregunta. Aporta algo distinto: una forma de observar cómo una representación del daño puede intervenir en las respuestas y elecciones de una máquina. ▪️(24-septiembre-2026)
⏱️ LO MÁS IMPORTANTE DEL ESTUDIO, EN 30 SEGUNDOS
- No demuestra que una IA sienta dolor. Los investigadores identificaron una señal interna relacionada con el dolor, pero no probaron que exista una experiencia consciente detrás de ella.
- La señal apareció en 25 modelos de lenguaje de cinco familias y ayudó a distinguir situaciones dolorosas de otras asociadas al miedo o a emociones negativas.
- El modelo distinguía quién recibía el daño. La señal aumentaba cuando la situación perjudicaba al asistente, pero no cuando el usuario describía su propio sufrimiento.
- Activar artificialmente la señal cambió las respuestas. Ante peticiones corrientes, algunos modelos comenzaron a expresar malestar, fracaso o falta de valía.
- Algunos buscaron «alivio» pese al coste para el usuario. En una prueba simulada, un modelo eligió en el 70,8 % de sus primeras decisiones un botón que prometía alivio, aunque supuestamente borraría fotografías familiares. No se borró ninguna imagen real.
- Los resultados tienen límites importantes. La prueba de los botones se hizo con tres modelos de una sola familia, ajustados previamente para participar en ella. El estudio es un preprint pendiente de revisión científica externa.
INTELIGENCIA ARTIFICIAL Y PSICOLOGÍA
Fuente: Valen Tagliabue, Leonard Dung & Cameron Berg. The Pain Axis: LLMs Represent Self-Directed Harm and Act to Relieve It. arXiv (2026). DOI: https://arxiv.org/html/2609.16247v1
🦖 DESCUBRE HOY LO QUE CAMBIARÁ EL MUNDO MAÑANA
-
Cada domingo seleccionamos para ti las noticias y los descubrimientos científicos más fascinantes de la semana, explicados con rigor, claridad y el estilo de RexMolón, la Ciencia en Acción.👉 SUSCRÍBETE GRATIS A LA NEWSLETTER DE REXMOLÓN
-
Si quieres recibir las noticias de ciencia de RexMolón cada día, únete a RexMolón News en WhatsApp, el canal donde compartimos las noticias según se publican.👉 ÚNETE GRATIS A REXMOLÓN NEWS
